深度学习赋能第一性原理计算 清华大学徐勇、段文晖研究组提出通用哈密顿网络
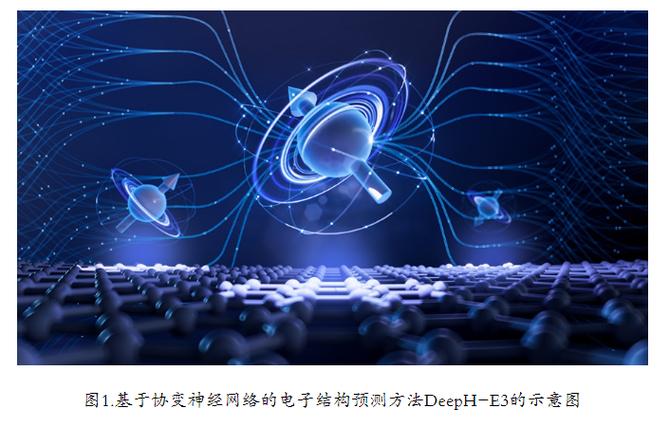
第一性原理计算方法,如密度泛函理论(DFT),在材料科学、凝聚态物理和化学等领域发挥着至关重要的作用。传统DFT计算的计算成本随着体系规模的增大而急剧上升,限制了其在大尺度复杂体系中的应用。机器学习与第一性原理计算的结合为突破这一瓶颈提供了新的思路。清华大学物理系徐勇副教授、段文晖教授研究组在这一方向上取得了重要进展,提出了深度学习第一性原理计算的通用哈密顿网络(Universal Hamiltonian Network),为实现高效、高精度的可迁移哈密顿量预测提供了新方案。
传统深度学习方法在原子模拟中多用于拟合势能面,即学习原子构型到总能量的映射。势能面方法难以直接给出电子结构信息,如能带、态密度等,而这些信息对于理解材料性质至关重要。为解决这一问题,徐勇、段文晖研究组将深度学习的目标对准了哈密顿量本身。哈密顿量是描述量子体系的核心对象,包含了体系的全部电子结构信息。如果能从原子构型直接预测哈密顿量,就可以通过对角化哈密顿量高效地获得能带结构和其他电子性质,从而绕开耗时巨大的自洽迭代过程。
该研究组提出的通用哈密顿网络基于图神经网络架构,将晶体结构表示为原子和键构成的图,通过消息传递机制学习局域原子环境与哈密顿量矩阵元之间的映射关系。网络的设计充分考虑了物理对称性,包括平移、旋转和置换不变性,保证了预测的哈密顿量满足体系的基本对称性要求。该方法采用了“局域化”策略,将全局哈密顿量分解为原子轨道基下的子矩阵块,每个块仅依赖于局域环境,从而实现了对大规模体系的线性缩放。
该工作的关键创新在于网络的“通用性”。传统的哈密顿量预测模型通常针对特定体系或特定材料类型训练,难以迁移到其他体系。而通用哈密顿网络通过引入注意力机制和更强大的表示能力,能够在多种材料(如金属、半导体、绝缘体)和不同元素组合上实现统一的预测。研究组在包含数千种晶体结构的数据集上训练了该网络,并测试了其在未知材料上的泛化性能。结果表明,该网络能够准确预测哈密顿量,进而得到的能带结构与DFT计算结果高度吻合,同时计算效率提升了数个数量级。
这一方法的意义在于,它为第一性原理计算提供了一种“预训练-微调”的新范式。用户可以在通用网络的基础上,针对特定体系进行少量微调,即可获得高精度的哈密顿量预测,从而大幅降低计算成本,使得大规模材料筛选和高通量计算成为可能。由于网络直接输出哈密顿量,它天然地提供了可解释的物理量,如轨道相互作用、 hopping参数等,有助于深入理解材料中的电子行为。
徐勇、段文晖研究组的工作展示了深度学习与量子力学相结合的潜力,为发展下一代第一性原理计算方法提供了重要思路。随着训练数据的不断丰富和网络架构的持续优化,通用哈密顿网络有望成为材料模拟和电子结构计算的标准工具之一,推动材料发现和基础物理研究的加速发展。这一成果也体现了清华大学物理系在计算凝聚态物理与人工智能交叉领域的前沿探索,为相关领域的研究者提供了有益的借鉴。
如若转载,请注明出处:http://www.sxslwj2.com/product/30.html
更新时间:2026-11-05 01:24:27